데이터 엔지니어 완전 마스터
데이터를 모으고(수집), 쌓고(저장), 쓸 수 있게 다듬고(변환), 매일 알아서 돌게 하는(오케스트레이션) 일을 처음부터 끝까지 직접 만들어 봅니다. 여기에 실제 채용 공고 93건이 요구하는 Kafka, CDC, Delta·Iceberg, 클라우드·Terraform, CI, 모니터링, RAG 파이프라인까지 더했습니다. 2026년 11월 기준 최신 버전으로 실제 실행해 확인한 내용만 담았고, 돌리지 못한 것은 그렇다고 표시했습니다.
ingest.py · dlt
DuckDB · DuckLake
dbt 2.0 테스트
Airflow 3.4
2026년 데이터 엔지니어에게 필요한 것
레딧 데이터 엔지니어 커뮤니티(r/dataengineering)에서 2026년 10~11월 가장 많은 추천을 받은 글 중 하나는 "파이프라인 만들던 일이 AI 챗봇용 시맨틱 레이어 만드는 일로 바뀌었다"는 글이었습니다. 코드 작성은 AI가 빠르게 도와주지만, 데이터가 언제 어디서 와서 어떻게 바뀌었는지 설명하고 검증하는 일은 여전히 사람 몫입니다. 이 교안은 도구 사용법보다 다시 돌려도 결과가 같은 적재, 틀린 데이터를 막는 테스트, 실패를 드러내는 오케스트레이션을 직접 만들어 보는 데 시간을 씁니다.
강의 흐름
역할과 기본기
데이터 엔지니어가 하는 일, 실습 환경, SQL 모델링과 파일 포맷.
- 00 데이터 엔지니어가 하는 일
- 01 실습 환경과 데이터
- 02 SQL과 데이터 모델링
- 03 CSV와 Parquet
파이프라인의 몸통
증분 적재, dlt로 API 수집, 레이크하우스, dbt 변환과 테스트, 그리고 증분 모델·스냅샷·단위 테스트까지 다루는 dbt 심화 6장.
- 04 증분 적재와 멱등성
- 05 dlt로 API 수집
- 06 웨어하우스·레이크·레이크하우스
- 07 dbt로 변환하기
- 08 데이터 품질과 테스트
- D01~D06 dbt 심화
Airflow 3.4 모듈 (11장)
설치, 첫 DAG, 시간대·백필, 재시도, Asset, Task Loops, 2→3 옮기기, 운영 판단까지. 이어서 캡스톤에서 앞의 모든 것을 DAG 하나로 묶습니다.
- A00~A10 Airflow
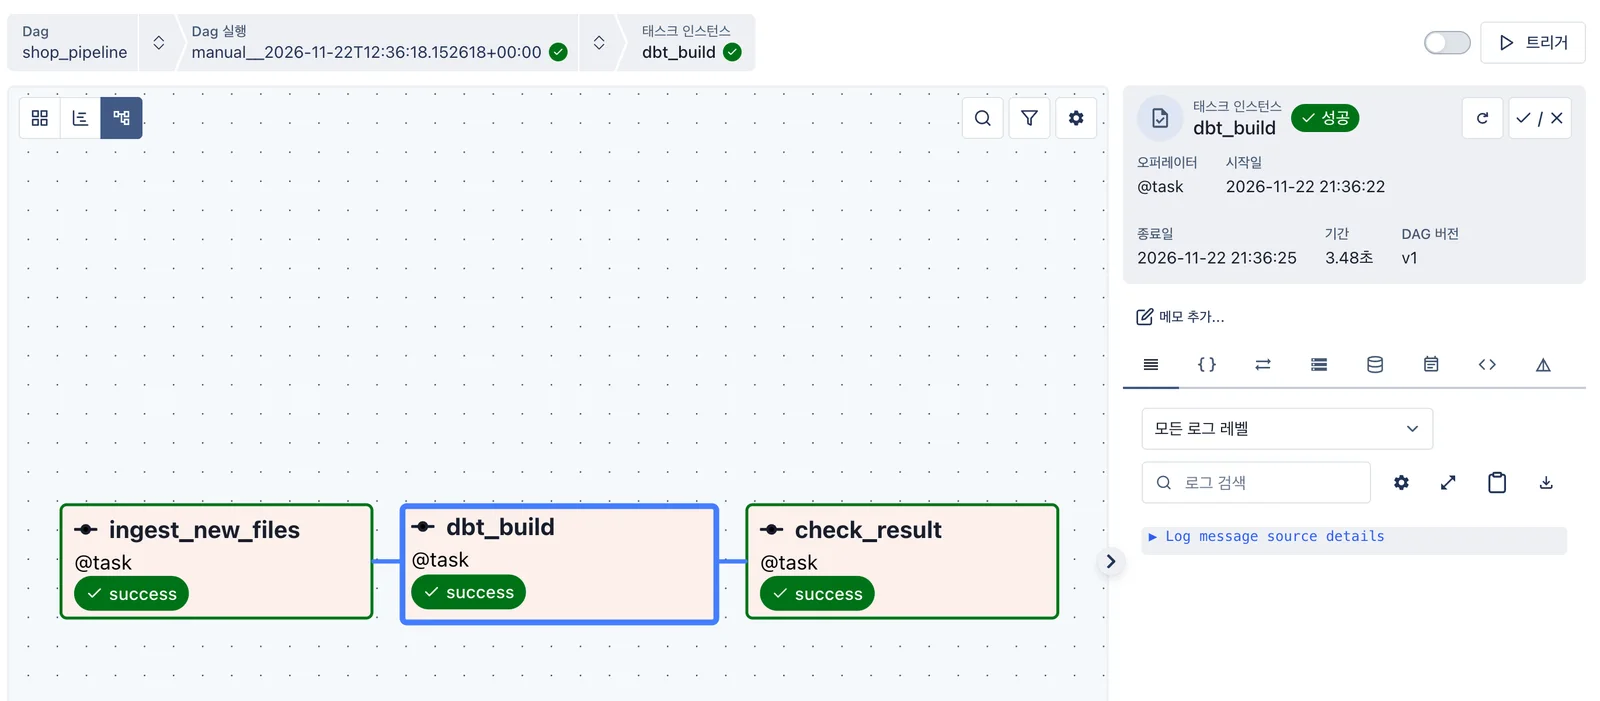
- 09 캡스톤: 적재 → dbt → 확인
규모, 운영, AI 시대
Spark가 필요한 때와 PySpark 실습, 스트리밍과 CDC, 운영과 보안, AI가 읽는 데이터, 포트폴리오와 면접.
- 10 Spark는 언제 필요한가
- S01~S04 PySpark 실습·튜닝
- 11 스트리밍과 CDC
- 12 운영·비용·보안
- 13 AI가 읽는 데이터
- 14 포트폴리오와 면접
채용 공고가 요구하는 것 (14장)
공고 93건을 세어 빠진 것을 채웠습니다. Kafka·스트림·CDC, Postgres, Git·CI, Delta·Iceberg, S3·Terraform, Docker·K8s, 클라우드 웨어하우스, 모니터링, 데이터 계약, RAG 파이프라인.
- X01~X03 파이썬·운영 DB·CI
- X04~X06 Kafka·스트림·CDC
- X07~X11 레이크하우스·클라우드
- X12~X14 모니터링·계약·RAG
이런 분께 맞습니다
- 데이터 엔지니어 취업을 준비하는데 무엇부터 해야 할지 순서가 필요한 분
- 분석가·백엔드 개발자로 일하며 파이프라인을 직접 만들어야 하는 분
- 예전 방식(cron, 수작업 SQL)으로 돌리던 작업을 테스트와 재실행이 되는 구조로 바꾸고 싶은 분
SQL SELECT문과 Python 함수를 읽을 수 있으면 따라올 수 있습니다. 모든 실습은 노트북 한 대에서 무료 도구로 합니다. 클라우드 실습은 계정 없이 로컬 흉내 서버(moto)로 합니다.